RTX 5090 1 枚で Qwen3.8-Flash-Next NVFP4 を FreeToken で約 260k 入力まで計測
RTX 5090 1 枚と RAM 96 GB の構成で、改修版 FreeToken による Qwen3.8-Flash-Next Uncensored NVFP4 の速度を測定しました。最大 259,601 トークン入力 + 1,000 トークン生成を含む 3 周・36 測定を完走し、最大入力での生成速度の中央値は 50.5 t/s、短い実用プロンプト 9 測定の中央値は 55.4 t/s でした。
- 作成者
- centra
- 作成日
- 2026-09-28
- コンピュータ / マザーボード
- ASRock Z890 Pro RS WiFi
- GPU
- NVIDIA GeForce RTX 5090 × 1
- モデル
- Qwen3.8-Flash-Next-Uncensored-NVFP4
- バックエンド
- FreeToken
- ベンチマーク
- FreeToken adapter (llama-split-bench protocol)
RTX 5090 1 枚で Qwen3.8-Flash-Next NVFP4 を FreeToken で約 260k 入力まで計測
- 作成者: centra
- 作成日: 2026-09-28
概要
RTX 5090 1 枚と RAM 96 GB の構成で、改修版 FreeToken による Qwen3.8-Flash-Next Uncensored NVFP4 の速度を測定しました。最大 259,601 トークン入力 + 1,000 トークン生成を含む 3 周・36 測定を完走し、最大入力での生成速度の中央値は 50.5 t/s、短い実用プロンプト 9 測定の中央値は 55.4 t/s でした。
llama-split-bench のプロンプトと測定段階を参照した FreeToken 用アダプタで実行しており、llama.cpp のネイティブ計時を取得した結果ではありません。モデルの派生・変換、推論エンジン、計時方法が異なるため、他の投稿との比較では以下の条件を併せて確認してください。
ハードウェア
| 項目 | 内容 |
|---|---|
| コンピュータ / マザーボード | ASRock Z890 Pro RS WiFi |
| GPU | NVIDIA GeForce RTX 5090 × 1(VRAM 32 GB / 枚) |
| GPU 接続 | PCIe Gen5 x16 |
| CPU | Intel Core Ultra 7 265K |
| メモリ | 96 GB(OS 表示約 93 GiB) |
| 電源 | 不明 |
ソフトウェア環境
| 項目 | 内容 |
|---|---|
| OS | NixOS 25.11 / Linux 6.12.93 |
| GPU ドライバ | NVIDIA 580.142 |
| バックエンド | 改修版 FreeToken a72b8e3979021888ee3f0a429a816e572c660605 + 計測用パッチ。llama.cpp は使用していません |
| Python / PyTorch | 3.12.13 / 2.11.0+cu130 |
| Triton / FlashInfer / Transformers | 3.6.0 / 0.6.18 / 5.16.1 |
| tokenizers | 0.23.1(測定環境で 2026-09-29 に後日確認) |
FreeToken のソースはこのコミットを参照してください。計測用パッチは添付しています。計測の間にモデル設定の変更や backend の再起動は行っていません。
ベンチマーク
条件
| 項目 | 内容 |
|---|---|
| ツール | FreeToken 用の独自アダプタ(llama-split-bench 7af72d4 のプロンプトと測定段階を参照。runner は未使用) |
| モデル | orcarouter/Qwen3.8-Flash-Next-Uncensored-NVFP4 を FreeToken 向けに変換したアーティファクト |
| 測定モード | 単一構成(RTX 5090 × 1)。llama-split-bench の --profile 相当 |
| ctx / stages | 262144 / 0,32000,64000,128000,196000,258000 |
| KV キャッシュ | K5V6 group32、10,000 pages × 64 = 640,000 tokens を共有 |
| 投機的デコード | MTP K=1、draft Expert NVFP4、draft cache 80 slots |
| Expert | NVFP4、host offload、GPU cache 4,816 slots(うち scratch 512) |
| 常駐重み | attention・shared expert・LM head は FP8 W8A16 |
| PLE | 約 47.684 GiB の FP8 host mmap |
| Mamba state / prefix state | 利用可能 32 slots(padding 用 1 slot を含む物理数は 33)/ linear-state-cache-ratio=0 |
| 1 要求の最大長 / prefill chunk | 262,144 tokens / 4,096 tokens |
| 同時処理 | 設定上限 8 要求、測定は 1 要求ずつ。vision もロードした通常の構成 |
| 繰り返し | 同じ入力・設定で 3 周。各周に 8 トークンの warmup |
| その他 | /v1/completions(raw completion、チャットテンプレートなし)。ladder / 新規 prefill は temperature 0・top_p 1・top_k 0・EOS 無視・生成 1,000 トークン / 段(新規 prefill は 64 トークン)、実用プロンプトは temperature 0.7・top_p 0.9・top_k 0・出力上限 1,200・EOS 許可・seed 固定なし |
モデルは FreeToken 向けに変換したアーティファクトを使用しました。元モデル名だけで変換済み重み・PLE を再現できるわけではありません。設定・tokenizer 等のハッシュと実際の環境変数は添付の run-info.json に保存しています。重み全体の同一性や他の量子化との品質同等性を検証した測定ではありません。
この FreeToken 版には起動時の Mamba slot 数を直接指定するオプションはなく、radix(本モデルでは hybrid_radix)・最大同時要求数 8・state cache 比率 0・MTP K=1 から、利用可能数が 4×8 + max(int(0×8), max(0,1−2)×8) = 32 と決まります。再現用 launcher はこの設定を明示し、adapter も /v1/stats の実数が 32 であることを確認してから測定します。
llama-split-bench との違い(計時とキャッシュ制御)
/v1/completionsを使用しました。scheduler で最初の prefill 受け入れ時刻と、既存の GPU 同期後に最初・最後の生成トークンを公開する時刻を記録しています。追加の GPU 同期やトークンごとのファイル書き込みは行っていません。- prefill 時間は受け入れから最初の公開までのホスト経過時間です。chunk 間処理、MTP catch-up、最初の sampling を含み、frontend の tokenize や受け入れ前の待機は含みません。CUDA kernel 時間の合計ではなく、llama.cpp のネイティブ timer との同一性は主張しません。
- decode 速度は、全生成数から最初の公開 batch のトークン数を引き、最初から最後の公開までの時間で割った値です。今回の最初の公開 batch は 1 トークンで、1,000 トークン生成時の分子は 999 となります。
- TTFT は独立にクライアントで測定しました。API usage と backend 計測の入力・再利用・生成トークン数を全要求で照合し、合成測定では出力数と終了理由も確認しています。
- prefix の消去は計測用コピーに加えた idle 時専用処理です。物理 KV pool・CUDA graph・Expert 常駐・PLE mmap を保持し、prefix 所有権と関連する空き状態を再構成します。通常の同容量 cache rebuild は準備時のメモリ予算再判定で拒否されたため、同じ物理容量を維持した消去処理を計測外で使用しました。
- MTP 採用率は基準の draft counter との対応を確認していないため、比較値を載せていません。計測用パッチとプロトコルを添付しています。
結果
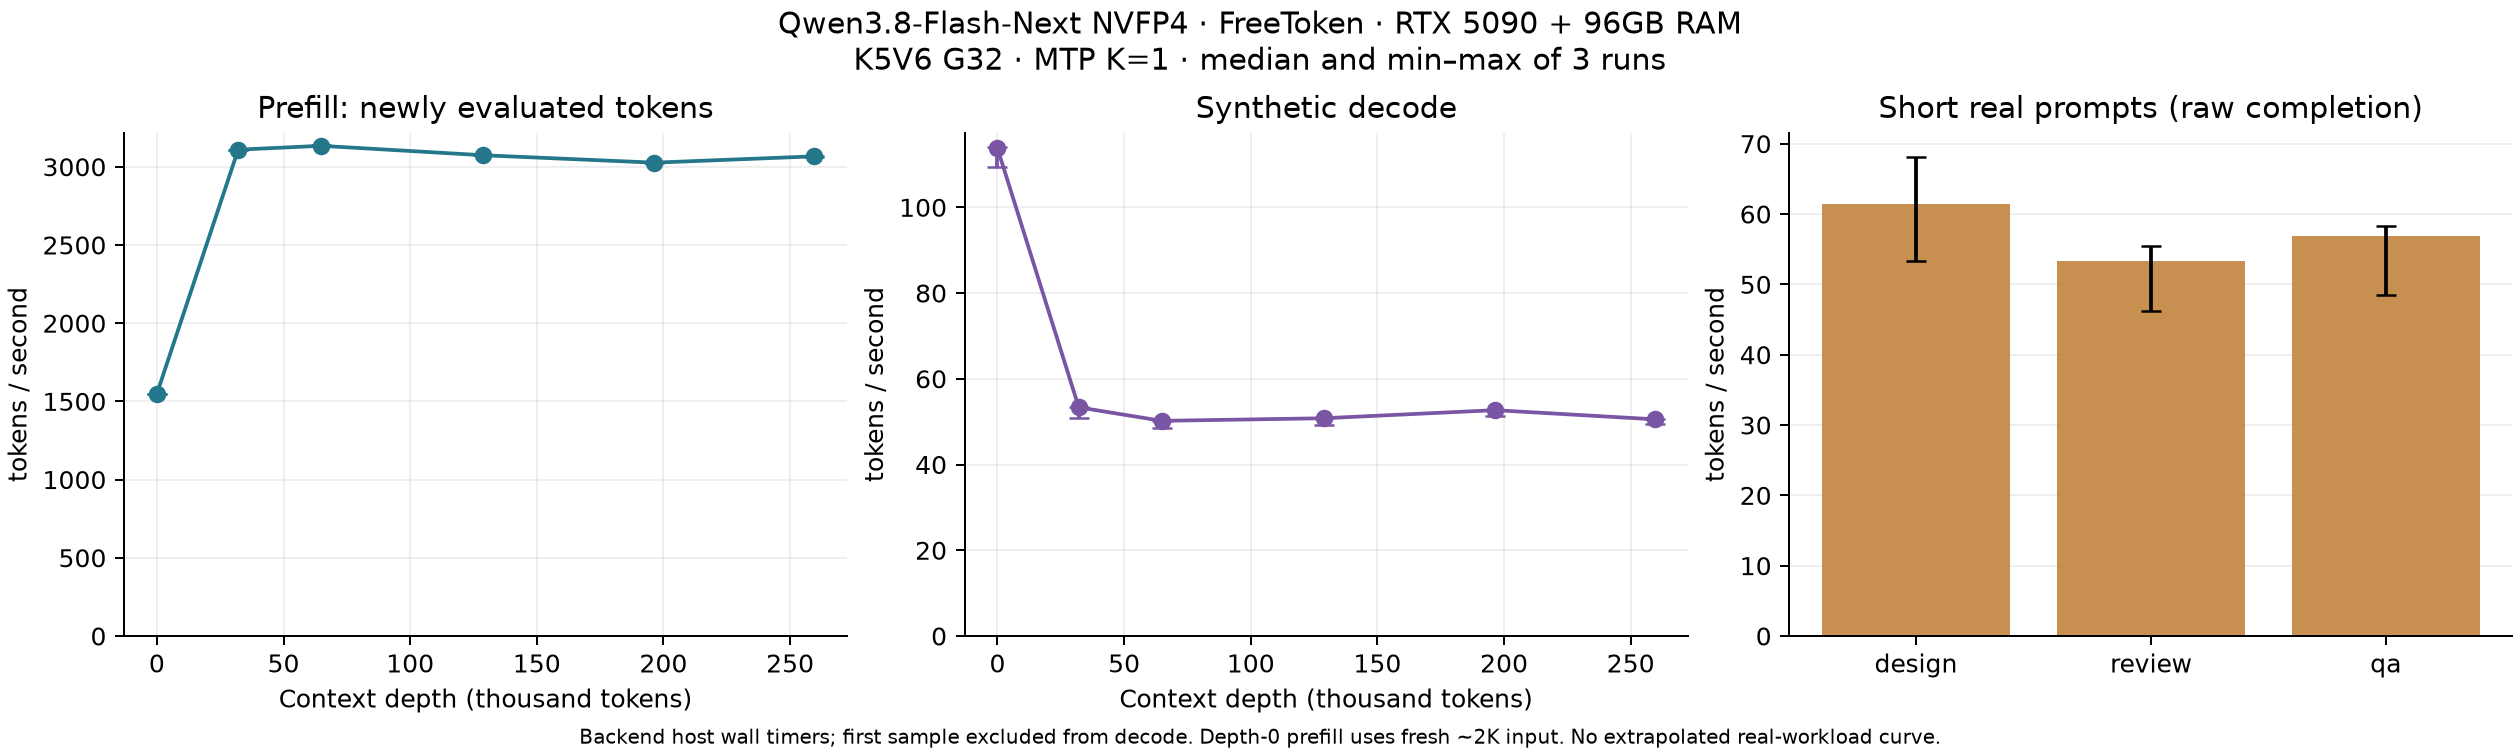
depth ごとの prefill / decode(t/s、各条件 3 回の中央値)。depth は名目の目標長で、実トークン数は次の表のとおりです。depth 0 の prefill は新規プロンプト(約 2k 入力)の値で、ラダー初段(11 トークン)の prefill は表に載せていません。
| depth | prefill (t/s) | decode (t/s) |
|---|---|---|
| 0 | 1548.9 | 113.8 |
| 32k | 3109.3 | 53.3 |
| 64k | 3133.9 | 50.2 |
| 128k | 3073.6 | 50.8 |
| 196k | 3026.2 | 52.7 |
| 258k | 3066.6 | 50.5 |
基準の繰り返し文と末尾指示を使用し、各段階で 1,000 トークン生成しました。depth 0 の生成は基準の短い首都の質問(実入力 11 トークン)を使用します。チャットテンプレートや thinking 無効化の指示は追加していません。
コンテキスト再利用の内訳(実入力と、3 回の prefill / decode の最小–最大):
| 名目 depth | 実入力 tokens | 再利用 tokens(3 回とも同じ) | 新しく評価した tokens | prefill 最小–最大 (t/s) | decode 最小–最大 (t/s) |
|---|---|---|---|---|---|
| 0(生成用) | 11 | 0 | 11 | — | 109.4–114.1 |
| 32k | 32,093 | 0 | 32,093 | 3,104.1–3,110.0 | 51.0–53.4 |
| 64k | 64,806 | 0 | 64,806 | 3,129.7–3,136.8 | 48.6–50.2 |
| 128k | 128,788 | 64,768 | 64,020 | 3,073.2–3,078.0 | 49.2–50.8 |
| 196k | 196,429 | 64,768 | 131,661 | 3,024.7–3,027.5 | 51.4–52.7 |
| 258k | 259,601 | 64,768 | 194,833 | 3,064.3–3,066.9 | 49.3–50.5 |
各周の最初に prefix cache を消去し、同じ周では再利用を許可しました。prefill 速度の分子は今回新しく評価したトークン数で、再利用されたトークンを含みません。32k・64k では再利用なし、128k 以降では 64,768 トークンを再利用しました。最大長の結果は、259,601 トークン全体を毎回新規に読み込んだ条件ではありません。
入力文は local tokenizer で長さを確認して一度だけ作成し、3 周で共用しました。stock が要求後に文字数/token 比を更新する方式とは少し異なります。最終的な長さにはサーバーが返したトークン数を使用しました。
depth 0 の新規プロンプト prefill(t/s、3 回の中央値と最小–最大):
| プロンプト長 | prefill (t/s) |
|---|---|
| 512 | 406.3(401.1–406.7) |
| 1978 | 1,548.9(1,547.0–1,550.3) |
| 8077 | 3,124.8(3,102.3–3,128.9) |
各入力前に prefix cache を消去し、基準の繰り返し文を入力して 64 トークン生成しました。ここで未使用状態にするのは KV prefix のみで、OS ページキャッシュ・Expert cache・PLE まで冷えた状態にはしていません。各周の測定順序は、新規 prefill、長文の連続測定、実用プロンプトの順です。warmup と事前 smoke は集計に含めていません。
実プロンプト(基準の design / review / qa をそのまま使用、各入力前に prefix cache を消去)の decode(3 回の中央値と最小–最大):
| プロンプト | 入力 tokens | decode (t/s) | クライアント TTFT (ms) | 出力 tokens(各回) |
|---|---|---|---|---|
| design | 73 | 61.4(53.4–68.1) | 1,338(1,272–1,874) | 1,200 |
| review | 58 | 53.4(46.2–55.4) | 1,273(1,267–1,700) | 1,200 |
| qa | 61 | 56.9(48.5–58.3) | 1,280(1,269–1,712) | 1,200 |
全 9 測定の生成速度中央値は 55.4 t/s(46.2–68.1)でした。すべて終了理由は length で、出力上限で打ち切られています。思考文もトークン数に含みます。回答を最後まで完了する速度や回答品質を評価した結果ではありません。これらの短い実用入力の値を、長文の実用速度へ外挿していません。
検証とリソース
長文 18 件、新規 prefill 9 件、実用 9 件の計 36 件を単一 backend instance で完了しました。長文 6 段階すべてで生成テキストの SHA-256 が 3 周とも一致しました。これは同条件での再現性を確認する補助チェックであり、内容の正しさを評価したものではありません。
2026-09-29 のレビュー対応で、再現用 adapter に開始時の instance ID を全要求・prefix reset と照合する検証を追加しました。要求間での再起動も検出して中断します。Mamba slot 数と tokenizers のバージョンも検証します。これらは測定後の再現用スクリプトの修正であり、掲載した測定値は変更していません。元の測定については保存ログを集計時に照合し、同一 instance・32 slots を確認しています。元ファイルのハッシュと改訂後の添付ハッシュは区別して保存しています。
2026-09-28 15:12〜15:29 JST の測定中、1 秒ごとに採取した 1,052 サンプルでは、GPU メモリ使用量の最大 31,356 MiB、空き最小 1,251 MiB、GPU 温度の最大 53°C、電力の最大 433.1 W、ホスト MemAvailable の最小 21.78 GiB でした。サブ秒の瞬間的なピークを保証する数値ではありません。
所感
- decode は 32k の 53.3 t/s から 258k の 50.5 t/s までほぼ一定で、深さによる低下がほとんど見られませんでした。prefill も新規評価分だけの分子で 3,000 t/s 台を 258k まで維持しました。depth 0 の decode 113.8 t/s は、基準と同じく短い質問プロンプト(11 トークン)での値です。
- 3 周のばらつきは小さく(長文 decode の最小–最大幅は 1.2〜2.4 t/s)、長文 6 段階すべてで生成テキストの SHA-256 が 3 周とも一致しました。
- 実用プロンプトの decode(全 9 測定の中央値 55.4 t/s)は、長文の合成テキスト decode と同程度でした。ただし FreeToken では MTP 採用率のカウンタとの対応を確認していないため、受理率込みでの比較はできていません。
- llama.cpp ではなく改修版 FreeToken + 計測用パッチによるホスト側計時で、128k 以降は 64,768 トークンの prefix 再利用を含みます。他レポートの llama-split-bench 値と同じ土俵の数値ではない点に注意してください。
添付
- グラフ PNG
- 集計 JSON、全条件 CSV(TXT 形式)
- 長文結果:1 周目・2 周目・3 周目
- 新規 prefill:1 周目・2 周目・3 周目
- 実用プロンプト:1 周目・2 周目・3 周目
- 設定・環境・元ファイルのハッシュ、プロトコル、再現手順
- アダプタ、起動スクリプト、リソース採取、計測用パッチ
- 再現用 adapter の検証(GPU 不要)
- 添付ファイルの SHA-256
スクリプト・パッチ・CSV はサイトの添付形式に合わせて .txt を付けています。生の生成文、プロンプト本文、server log、モデルファイルは含めていません。CSV の depth 0 の prefill は実入力 11 トークンの生測定値であり、本文の代表表・グラフで用いた新規約 2k の値とは区別して保存しています。
プロトコルの参照元:llama-split-bench 固定版。