TB250-BTC PRO で新旧混成 GPU の分割ベンチ (Vulkan + Kepler 復活 CUDA)
BIOSTAR TB250-BTC PRO(マイニングボード、Celeron G3930 / 32 GiB)に差した 5 枚の GPU + iGPU のうち、実際に計測できた全構成を個別・分割で比較しました。
- 作成者
- eightman999
- 作成日
- 2026-10-04
- コンピュータ / マザーボード
- BIOSTAR TB250-BTC PRO(マイニングボード)
- GPU
- R × 6400
- モデル
- Qwen3-1.7B Q4_K_M
- バックエンド
- 不明
- ベンチマーク
- 不明
TB250-BTC PRO で新旧混成 GPU の分割ベンチ (Vulkan + Kepler 復活 CUDA)
- 作成者: eightman999
- 作成日: 2026-10-04
概要
BIOSTAR TB250-BTC PRO(マイニングボード、Celeron G3930 / 32 GiB)に差した 5 枚の GPU + iGPU のうち、実際に計測できた全構成を個別・分割で比較しました。
- Vulkan 系(RADV): RX 6400(PCIe 4.0 x16)と Pro WX 2100(PCIe 2.0 x1 ライザー)の単体 + layer/tensor 分割を Qwen3-1.7B Q4_K_M・ctx 8192 で測定
- CUDA 系(sm_35 復活): 旧 Kepler の GT 730 / GT 710 を、NVIDIA 470.256.02 ドライバ(Debian パッチ適用)+ CUDA 11.4 + sm_35 向けパッチ済み llama.cpp で動かし、TinyLlama-1.1B Q4_0・ctx 2048 で単体 + 分割を測定
- CPU: Celeron G3930(2C2T)も同一モデル・同一条件で測定
結果、分割構成はいずれも「速い方のカード単体」を上回れないことが確認できました。特に PCIe 2.0 x1 経由の tensor 分割は同期コストが支配的で、decode が単体の 1/5 程度まで落ちます。旧 Kepler 2 枚でも同じ傾向で、GT 730 単体 13.3→9.8 t/s に対し tensor 分割は 11.6→8.8 t/s に留まりました。
iGPU(HD Graphics 610)は Vulkan 計測中に ErrorDeviceLost で GPU ハングを繰り返し、有効なラダー計測が不可能だったため除外しました。GT 430(Fermi)は当初全経路が塞がれていましたが、NVIDIA 390.157 + OpenCL/CLBlast 経路で推論動作を確認しました(追記セクション参照。PCIe x1 越えの同期コストで CPU より遅いためベンチ対象には含めていません)。
ハードウェア
| 項目 | 内容 |
|---|---|
| コンピュータ / マザーボード | BIOSTAR TB250-BTC PRO(マイニングボード) |
| GPU | RX 6400 4GB(Navi 24)/ Pro WX 2100 2GB(Polaris 12)/ GT 730 1GB GDDR5(GK208B)/ GT 710 2GB DDR3(GK208B)/ GT 430 1GB DDR3(GF108 Fermi、OpenCL 経路で動作確認・追記参照)+ iGPU HD Graphics 610(計測不能で除外) |
| GPU 接続 | RX 6400: PCIe 4.0 x16 直挿し。WX 2100 含む残り全スロット: PCIe 2.0 x1 ライザー(実効 ~500 MB/s) |
| CPU | Intel Celeron G3930 @ 2.90 GHz(2 コア / 2 スレッド、Kaby Lake) |
| メモリ | 32 GiB |
| 電源 | 不明 |
ソフトウェア環境
| 項目 | 内容 |
|---|---|
| OS | Debian GNU/Linux 13 (trixie) / Linux 6.12.107+deb13-amd64 |
| GPU ドライバ | amdgpu / i915(KMS、RADV 経由の Vulkan)+ NVIDIA 470.256.02(Debian nvidia-tesla-470-kernel-dkms 470.256.02-9、bookworm ソースから DKMS 導入。nouveau は blacklist) |
| llama.cpp (Vulkan) | llama-b11384 公式 prebuilt(ubuntu-vulkan-x64)、Vulkan バックエンド |
| llama.cpp (Kepler) | 同 b11384 ベースの自前ビルド。CUDA 11.4 + gcc-10.2.1(bullseye chroot)で CMAKE_CUDA_ARCHITECTURES=35。ggml-cuda/common.cuh に pre-Volta warp-intrinsic shim を追加(__shfl_*_sync 系をレガシー組込みへマップ) |
| 計測ツール | llama-split-bench(同梱 run-bench.sh) |
Kepler 復活の経緯
GT 730/710(GK208B, sm_35)は現行スタックでは全経路が塞がれていました(Vulkan 非対応、nvidia 現行ドライバ非対応、CUDA 12 は sm_35 を吐けない)。以下で復活させました:
- Debian bookworm の
nvidia-tesla-470-kernel-dkms 470.256.02-9を取り込み(Linux 6.12 対応パッチ群を内蔵)、DKMS でカーネルモジュールビルド - nouveau 環境下では
RmInitAdapter failed (0x45:2315)で init 失敗 → nouveau blacklist + initramfs 更新 + 冷起動で正常認識(BIOS POST 済み状態が必要だった模様) - llama.cpp b11384 は sm_35 でコンパイルは通るが
__shfl_sync等の Volta 以降 intrinsic が露出 → 事前 shim を当ててビルド(kepler-sm35-shim.patch) - CUDA 11.4 は driver 470 が対応する上限のため bullseye chroot にツールキットのみ導入
なお計測ツール側にも修正を入れています: 旧ドライバの nvidia-smi --query-compute-apps が [N/A] を返し measure_ladder.py の guard がクラッシュするため、非数値 PID をスキップするよう緩和しました(本リポジトリ外の変更)。
計測不能デバイス
| デバイス | 経緯 |
|---|---|
| Intel HD Graphics 610 | ANV で Vulkan は列挙されるが、depth 4096 付近で vk::Queue::submit: ErrorDeviceLost(GPU ハング→リセット)を再現性よく起こし、ラダーが完走しない。hangcheck を切れば序盤は動くが除外判断 |
| GT 430 (Fermi, GF108) | 当初は計測不能と判断: 470 は Kepler 以降のみ対応(390.xx が必要だが kernel 6.12 では成立困難と見込み)、nouveau では failed to create ce channel, -22 で初期化失敗、Mesa Clover にも列挙されず。→ 後日 390.157 + OpenCL/CLBlast 経路で動作確認(下記追記参照) |
デバイス番号
| llama.cpp | 実 GPU |
|---|---|
| Vulkan0 | Intel HD Graphics 610(除外) |
| Vulkan1 | RX 6400 |
| Vulkan2 | Pro WX 2100 |
| CUDA0 | GT 730(nvidia-smi index 0 と一致) |
| CUDA1 | GT 710 |
ベンチマーク
条件
| 項目 | Vulkan 系 | CUDA 系(Kepler) |
|---|---|---|
| モデル | Qwen3-1.7B Q4_K_M(~1.2 GB) | TinyLlama-1.1B Q4_0(~0.6 GB、n_ctx_train=2048 のため ctx=2048) |
| ctx / stages | 8192 / 0,2048,4096,8192 | 2048 / 0,512,1024,1792 |
| 生成トークン / 段 | 300 | 150 |
| KV キャッシュ | q8_0 / q8_0 | q8_0 / q8_0 |
| その他 | -ngl all -fa on -t 2 --jinja |
同左 |
| 測定構成 | rx6400 / wx2100 / 両者 layer / 両者 tensor / cpu | gt730 / gt710 / 両者 layer / 両者 tensor |
結果(Vulkan / Qwen3-1.7B)
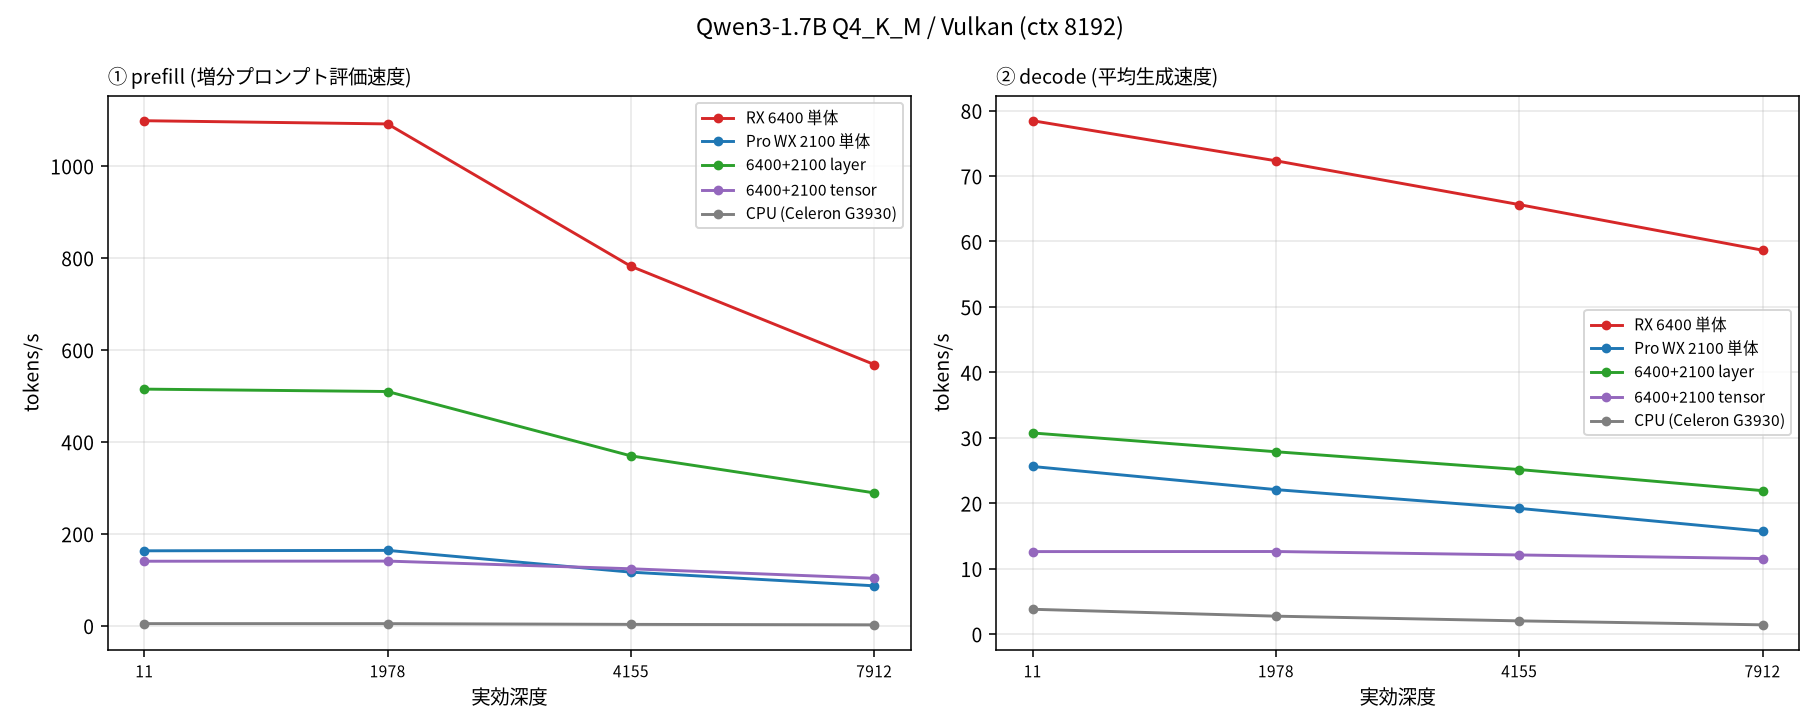
depth ごとの prefill / decode(t/s)。depth 0 の prefill は新規プロンプト(pp2048)の値です。ラダー初段(約 11 トークン)の prefill はウォームアップ計測のため表に載せていません。
| depth | pp rx6400 | pp wx2100 | pp layer | pp tensor | pp cpu | dec rx6400 | dec wx2100 | dec layer | dec tensor | dec cpu |
|---|---|---|---|---|---|---|---|---|---|---|
| ~0 | 1098.2 | 162.8 | 514.5 | 140.2 | 4.50 | 78.4 | 25.6 | 30.7 | 12.6 | 3.77 |
| 1978 | 1091.2 | 163.8 | 509.3 | 140.5 | 4.4 | 72.3 | 22.1 | 27.8 | 12.6 | 2.71 |
| 4155 | 781.6 | 116.4 | 369.3 | 123.8 | 2.8 | 65.6 | 19.2 | 25.1 | 12.1 | 2.00 |
| 7912 | 568.0 | 86.7 | 288.8 | 103.0 | 1.9 | 58.7 | 15.7 | 21.9 | 11.5 | 1.39 |
depth 0 の新規プロンプト prefill(t/s):
| プロンプト長 | rx6400 | wx2100 | layer | tensor | cpu |
|---|---|---|---|---|---|
| 512 | 1254.1 | 186.2 | 466.1 | 147.7 | 5.07 |
| 2048 | 1098.2 | 162.8 | 514.5 | 140.2 | 4.50 |
結果(CUDA sm_35 / TinyLlama-1.1B)
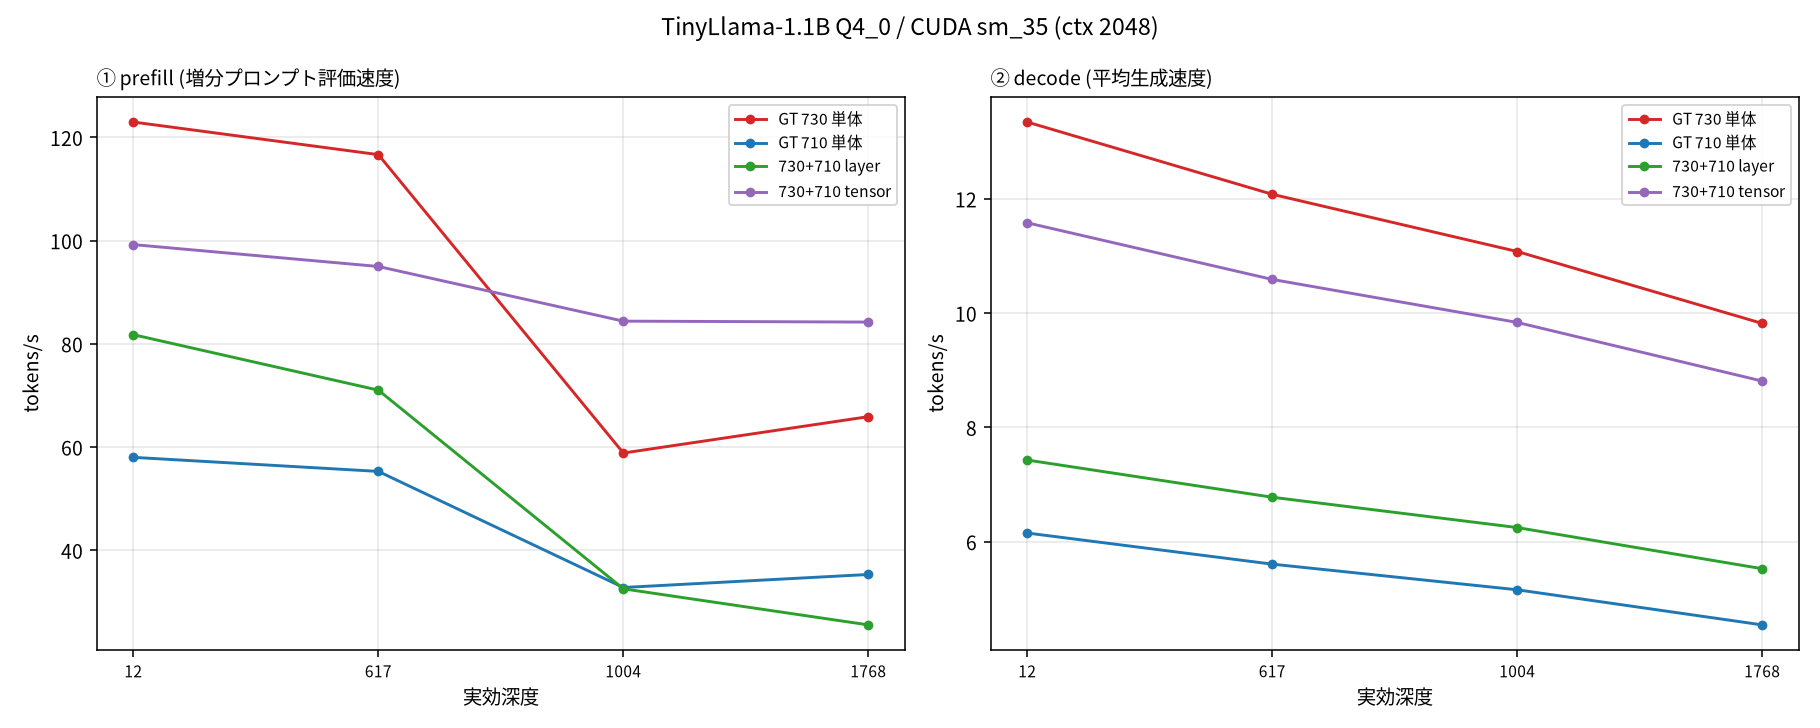
depth 0 の prefill は新規プロンプト(pp1024)の値です。初段のウォームアップ計測は除外しています。
| depth | pp gt730 | pp gt710 | pp layer | pp tensor | dec gt730 | dec gt710 | dec layer | dec tensor |
|---|---|---|---|---|---|---|---|---|
| ~0 | 123.0 | 58.0 | 81.8 | 99.2 | 13.3 | 6.2 | 7.4 | 11.6 |
| 617 | 116.7 | 55.3 | 71.0 | 95.0 | 12.1 | 5.6 | 6.8 | 10.6 |
| 1004 | 58.9 | 32.8 | 32.6 | 84.4 | 11.1 | 5.2 | 6.2 | 9.8 |
| 1768 | 65.9 | 35.3 | 25.6 | 84.2 | 9.8 | 4.5 | 5.5 | 8.8 |
depth 0 の新規プロンプト prefill(t/s):
| プロンプト長 | gt730 | gt710 | layer | tensor |
|---|---|---|---|---|
| ~512 | 121.6 | 57.6 | 74.1 | 98.3 |
| ~1024 | 123.0 | 58.0 | 81.8 | 99.2 |
追記: GT 430 (Fermi) — NVIDIA 390.157 + OpenCL/CLBlast 経路(2026-10-04 夜)
ユーザ要望により、Fermi (sm_21) を 2023 年当時の llama.cpp + OpenCL/CLBlast スタックで動かす実験を追加で実施しました。
ドライバ: Debian bookworm の nvidia-legacy-390xx-kernel-dkms 390.157-16(6.12 対応パッチ群内蔵)を DKMS ビルド・導入し、NVIDIA 公式 .run (390.157) で userspace を導入。nvidia-smi で GT 430 / GT 730 / GT 710 の 3 枚を認識。
ハマり所:
- 390 ロード中に 470 が再自動ロードされ、userspace 不一致で
GPU access blockedになる → 470 を明示 unload で解決 clinfoに NVIDIA platform が出ず、NVIDIA OpenCL ICD がclGetExportTableで segfault → 真因は/dev/nvidia-uvmの major 不一致(390 uvm は major 237 で登録されるが 470 時代の 235 ノードが残存)。mknod作り直しで即座に解決し、clinfoに NVIDIA CUDA platform(OpenCL 1.2 CUDA 9.1.84)+ GT 430 OpenCL 1.1 が列挙されるようになった
llama.cpp: 2e6cd4b(2023-05-23、CLBlast 導入の merge commit そのもの)を make LLAMA_CLBLAST=1(clblast 1.6.3)でビルド。デバイス選択は GGML_OPENCL_PLATFORM=0 GGML_OPENCL_DEVICE=1。
モデル: このコミットは GGJT v3 のみ受け付け GQA 非対応のため、TinyLlama-1.1B(GQA)はロード不可。非 GQA の OpenLLaMA-3B を当時の convert.py で変換(BF16 safetensors を uint16 読み+bit shift で F32 デコードするパッチを追加)。llama.cpp 側にも MODEL_1B/3B 登録 + n_mult=8640 ヘッダ修正が必要だった(llama-2023-clblast-port.patch)。
結果(OpenLLaMA-3B Q4_0 1.93GB, ctx=512, eval 31 トークン):
| 構成 | decode | VRAM |
|---|---|---|
| CPU のみ (ngl=0) | 4.91 t/s | — |
| GT430 ngl=4 | 2.40 t/s | ~270 MB |
| GT430 ngl=6 | 1.90 t/s | ~400 MB |
| GT430 ngl=8 | 1.58 t/s | 531 MB |
| GT430 ngl=10 | 1.35 t/s | 664 MB |
| GT430 ngl=12 | 起動はするが推論中に clEnqueueNDRangeKernel が -4(CL_MEM_OBJECT_ALLOCATION_FAILURE) |
797 MB |
| GT730 ngl=10 | 2.61 t/s | 664 MB |
| GT710 ngl=20 | 0.84 t/s | 1328 MB |
| GT710 ngl=26 | 1728 MB 載るが prompt 用 dequant バッファ(出力層 fp32 で ~410 MB 級)で -4 | — |
所感: GT 430 での推論は動作する(生成も正常: “Tokyo, the largest city in Asia...” 等)。ただし PCIe x1 ライザー経由ではオフロード 1 層あたり +55 ms/token と純粋に逆効率で、AVX2 すらない Celeron CPU 単独(4.91 t/s)を大きく下回る。Kepler 2 枚も CLBlast 経路では CUDA sm_35 実測(GT 730: 13.3→9.8 t/s)に遠く及ばず。このため OpenCL 路線が動いた時点で CUDA 8 + 8944a13 フォールバックは不要と判断し未実施。
所感
- 分割は常に「速いカード単体」に負ける。Vulkan でも CUDA/Kepler でも、layer 分割は遅いカードの律速になり、tensor 分割は x1 リンクの同期コストで単体以下。今回の 2 つの系統で同じ結論が再現しました。
- Vulkan 系の落差が顕著: tensor 分割の decode は全深度で ~12 t/s(RX 6400 単体の 1/5)。WX 2100 が PCIe 2.0 x1(実効 ~500 MB/s)で、テンソル分割はレイヤごとに双方向同期するため帯域貧弱なリンクでは致命的。layer 分割ですら RX 6400 単体の半分以下。
- Kepler 側は僅差: tensor 分割 8.8〜11.6 t/s vs GT 730 単体 9.8〜13.3 t/s。TinyLlama は小さいため同期オーバーヘッドが相対的に小さく、かつ DDR3 の GT 710 に重い層を逃がす効果もあり単体に近づくが、超えることはなかった。
- GT 710 (DDR3) は重荷: decode 4.5〜6.2 t/s。GDDR5 の GT 730 と倍近い差があり、layer 分割では完全に律速側。
- CPU は実用圏外: Celeron G3930 で decode 3.8 t/s 程度(深い depth では更に低下)。旧 Kepler GPU でも CPU の 2〜3 倍は出るため、sm_35 復活の意義は十分ありました。
- VRAM 制約: GT 730 (1GB) には Qwen3-1.7B Q4_K_M は KV 込みで入らず TinyLlama を採用。モデルが異なるため Vulkan 系との直接比較は不可(GT 730 の TinyLlama decode 13.3 t/s は Qwen3 換算ではさらに下がる見込み)。
添付
- run-info-vulkan.json / run-info-cuda.json
- kepler-sm35-shim.patch(llama.cpp b11384 を sm_35 でビルド可能にする pre-Volta warp-intrinsic shim)
- llama-2023-clblast-port.patch(llama.cpp 2e6cd4b 向け: convert.py の BF16 safetensors 対応 + head_dim=100 推定、llama.cpp の MODEL_1B/3B 登録)
- fermi-clblast-notes.txt(390.157 環境の nvidia-smi/clinfo 出力と CLBlast ngl スイープ結果)
- 各アームの results-.json / results--pp0.json / argv-*.txt(attachment ディレクトリ内)